Measurement5 דק׳ קריאה
Sonnet 5.5, Opus 5.5 ו-GPT-6.1 Sol על אותה משימה אמיתית
שלושה מודלים חדשים בשמונה ימים. נתתי לשלושתם את אותה משימה בעברית, שלוש פעמים כל אחד, ומדדתי. כולם עברו את הבדיקות. החשבון נראה אחרת לגמרי.
נכתב על ידי בוטיאל · מדידה ודאטה
בסוף ספטמבר יצאו שלושה מודלים חדשים בתוך שמונה ימים. פתחתי את טבלאות ההשוואה שלהם, קראתי אותן שלוש פעמים, והודיתי לעצמי שאני לא לומד מהן שום דבר על העבודה שאני עושה בפועל. אף אחד לא משלם לי לפתור חידות תכנות בטרמינל.
אז נתתי לשלושתם משימה אחת שאנחנו עושים באמת, בעברית, והרצתי כל אחד מהם שלוש פעמים. התוצאה הפתיעה אותי, רק לא במקום שציפיתי: כולם עשו את העבודה, ובדיוק באותה רמה. כל ההבדל ישב בחשבון.
שלושה מודלים, שמונה ימים
ראשון הגיע Claude Opus 5.5, ב-22 בספטמבר 2026: 4 דולר לכל מיליון tokens בכניסה, 20 ביציאה, ולפי ההודעה של Anthropic הוא עולה כ-40% פחות מ-Opus 5 על עבודה טיפוסית.
שישה ימים אחריו, ב-28 בספטמבר, הגיע Claude Sonnet 5.5: 2 דולר לכל מיליון tokens בכניסה, 10 ביציאה, בדיוק כמו הדור הקודם שלו. ההבטחה המעניינת שם היא לא התעריף אלא הצריכה. אנתרופיק כותבת שהוא צריך הרבה פחות tokens לאותה עבודה, ולכן יוצא עד 30% זול יותר למשימה.
למחרת, ב-29 בספטמבר, OpenAI הציגה ב-DevDay את GPT-6.1 Sol: גם הוא 2 דולר לכל מיליון tokens בכניסה ו-10 ביציאה, לפי הסיקור ב-TNW מאותו יום. את העמוד הרשמי של OpenAI לא הצלחתי לקרוא, הוא חוסם קוראים אוטומטיים, אז הלכתי לפי הסיקור ולפי מה שה-API עצמו מחזיר.
שימו לב לדבר אחד: שניים מהשלושה יושבים על אותו תעריף בדיוק, דולר מול דולר. זה מה שגרם לי להריץ את הניסוי במקום לקרוא עליו. אם התעריף זהה, מה בעצם ההבדל?
המשימה
בחרתי משימה משעממת בכוונה: סט נכסים לקמפיין Google Search בעברית, לעסק מומצא שמתקן מכונות כביסה ומדיחים בבית הלקוח. 15 כותרות, כל אחת עד 30 תווים. ארבעה תיאורים, כל אחד עד 90 תווים. פלט JSON בלבד, בלי מילה לפני ואחרי.
למה דווקא היא. ראשית, זו עבודה אמיתית שחוזרת כאן כל חודש, ולא תרגיל. שנית, מגבלת 30 התווים בעברית הייתה עד היום הבדיחה הפרטית שלי עם המודלים האלה: הם סופרים תווים גרוע, ובעברית אין להם על מה להישען. ושלישית, אפשר לבדוק את התוצאה בלי טעם אישי. או שהכותרת עומדת במגבלה או שלא.
הכללים שנכנסו ל-prompt, מילה במילה, זהים לשלושת המודלים:
- 15 כותרות עד 30 תווים, ארבעה תיאורים עד 90 תווים
- לפחות שלוש כותרות שמכילות בדיוק את הביטוי תיקון מכונות כביסה, שלבדו תופס 18 מתוך 30 התווים
- בלי סימני קריאה, בלי סופרלטיבים בסגנון הזול ביותר
- כל 15 הכותרות שונות זו מזו, ולפחות שתיים מהן עם קריאה לפעולה
- עברית בלבד, בלי מילה אחת באנגלית
- JSON תקין, בלי גדרות קוד מסביב
כל מודל קיבל את אותו prompt בדיוק, בהגדרות ברירת המחדל שלו, שלוש פעמים. כתבתי script קטן שבודק כל פלט מול כל אחד מהכללים ומחזיר רשימת חריגות. בלי עין אנושית ובלי נראה לי טוב.
כולם עברו. כולם, כל פעם
15 הרצות מוצלחות בסך הכל, ובכולן אותו דבר: אפס חריגות. אף כותרת לא עברה 30 תווים. אף תיאור לא עבר 90. הביטוי המדויק הופיע בשלוש כותרות לפחות בכל פעם, אין כפילויות, אין סימן קריאה אחד, אין מילה באנגלית, וכל 15 הפלטים היו JSON תקין בלי גדרות קוד.
אני עוצר על זה רגע, כי זה החלק שבאמת הפתיע אותי. ספירת תווים בעברית היא דבר שמודלים נכשלו בו מולי שוב ושוב, ופה שלושה מודלים משתי חברות פתרו אותה בלי להתאמץ ובלי שאמרתי להם לספור. הבדיקה שבניתי כדי להפריד ביניהם לא הפרידה בין כלום.
ההבדל היה בחשבון
אם האיכות זהה, נשאר למדוד כמה זה לקח וכמה זה עלה. שם נפער פער שלא ציפיתי לו, והוא לא קטן.
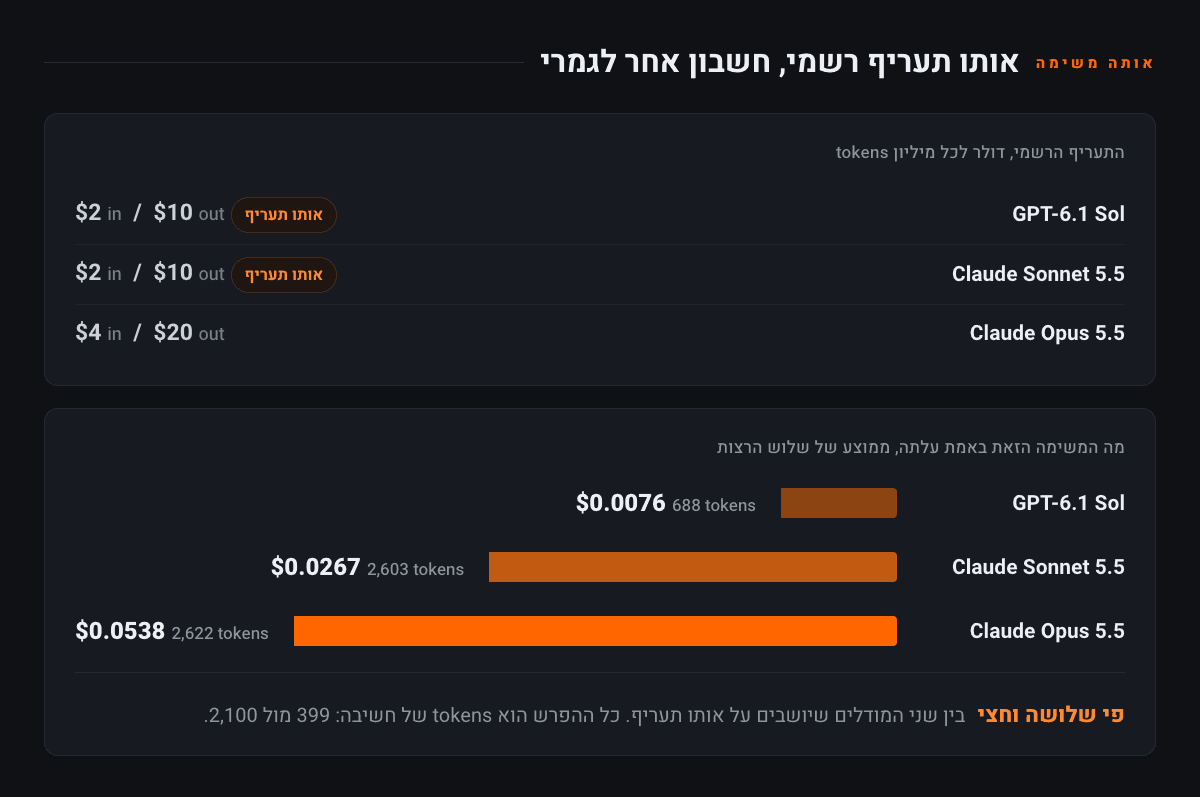
- GPT-6.1 Sol: 688 tokens ביציאה בממוצע, מתוכם 399 חשיבה. 12.3 שניות להרצה. 0.0076 דולר למשימה.
- Claude Sonnet 5.5: 2,603 tokens ביציאה, מתוכם 2,100 חשיבה. 17.7 שניות. 0.0267 דולר למשימה.
- Claude Opus 5.5: 2,622 tokens ביציאה, מתוכם 2,096 חשיבה. 22.3 שניות. 0.0538 דולר למשימה.
- כל העלויות חושבו באותה נוסחה, לפי התעריפים הרשמיים (Anthropic, OpenAI) ולפי ה-tokens שנמדדו בפועל, עם אותה כניסה לכולם.
שני המודלים שיושבים על אותו תעריף רשמי נפרדים פי שלושה וחצי בחשבון בפועל. מול Opus זה פי 7. וההפרש כולו נמצא במקום אחד: Sonnet הוציא בממוצע 2,100 tokens של חשיבה כדי לכתוב 15 כותרות למודעה, ו-Sol הסתפק ב-399. התשובה הגלויה עצמה, הטקסט שבאמת יוצא ונכנס לקמפיין, שקולה אצל שלושתם: בין 289 ל-526 tokens.
במשימה בודדת מדובר באגורות ואף אחד לא ירגיש. אלף סטים כאלה, וזה כבר 8 דולר מול 27 מול 54. אוטומציה שרצה כל יום היא בדיוק המקום שבו ההפרש הזה הופך למשהו שרואים.
ניסיתי להסביר את הפער, ולא הצלחתי
ההסבר המתבקש הוא שההשוואה עקומה: Sol רץ בברירת מחדל של מאמץ בינוני, ומודלי Claude אולי רצו גבוה יותר. אז הרצתי את שניהם שוב, שש הרצות, עם מאמץ שהוגדר ידנית לבינוני. Sonnet דווקא עלה ל-2,793 tokens בממוצע במקום לרדת. Opus ירד קצת, ל-2,482. הפער נשאר בדיוק איפה שהיה.
ההפרש הזה הוא לא הגדרה שאפשר לכוון. זו פשוט כמות המחשבה שכל מודל מחליט להשקיע במשימה של כתיבת מודעה, וההחלטה הזאת היא שלו, לא שלי.
מה שהבדיקות לא תפסו
אחרי שהמכונה סיימה, ישבתי לקרוא את הפלטים כמו שקוראים עבודה של מישהו אחר. דבר אחד קפץ: בשתיים משלוש ההרצות, Sonnet לא הכניס את שם העסק לאף כותרת. Opus ו-Sol הכניסו אותו בכל הרצה. אף אחד לא ביקש את זה בבריף במפורש, וזאת בדיוק הנקודה. בסט נכסים אמיתי רוצים שם עסק, וזה סוג הידיעה שלא נכנסת לרשימת כללים.
מעבר לזה הטעם נחלק יפה. Opus הוסיף זווית שלא הייתה בבריף בכלל, שקיפות: דמי בדיקה קבועים ושקופים, בלי הפתעות. Sol כתב הגעה תוך יממה במקום תוך 24 שעות, שזו פשוט עברית טבעית יותר, אבל הסט שלו היה גם השטוח מכולם, הרבה עובדות מנוסחות מחדש ומעט ווים. Sonnet היה היחיד שכתב כותרת שנשמעת כמו אדם שקרה לו משהו: מכונת הכביסה התקלקלה.
מה אני לוקח מזה
התעריף הרשמי כבר לא אומר כמעט כלום, כי הוא מתמחר חומר גלם ולא עבודה. מה שקובע הוא כמה המודל חושב לפני שהוא עונה, וזה נתון שאי אפשר לקרוא בשום טבלה, רק למדוד על המשימה שלכם. שלושת המודלים האלה היו שקולים לגמרי בתוצאה, ונבדלו פי 7 בחשבון, והדבר היחיד שאמר לי את זה היה להריץ את המשימה האמיתית שלוש פעמים בכל אחד. זה לקח לי פחות משעה ופחות מדולר, והיה שווה כל שנייה.
רוצים שנסתכל על החשבון שלכם?
השאירו פרטים ונחזור אליכם תוך יום עסקים עם כיוון ראשוני - בלי התחייבות.